Robots.txt говорит поисковому роботу, куда не ходить, а sitemap.xml - какие страницы важны и когда они обновились. На их правильную настройку уходит обычно 1-2 часа, а одна строка Disallow: /, забытая после разработки, способна за 2-4 недели убрать сайт из выдачи целиком.
I. Зачем сайту эти два файла
Поисковый робот приходит на сайт с ограниченным запасом внимания. Если на сайте 300 полезных страниц и 5000 технических адресов - фильтры каталога, корзина, страницы поиска, UTM-метки, - робот тратит обход на мусор, а новые статьи и услуги ждут индексации неделями. Robots.txt отсекает мусор, sitemap.xml подсказывает, что проиндексировать в первую очередь.
Важно понимать разницу. Robots.txt - это запрет на обход, а не на показ: страница, на которую много ссылок, может попасть в выдачу и без обхода. Чтобы гарантированно убрать страницу из индекса, нужен мета-тег noindex или ответ 404/410, а не только строка в robots.txt. Sitemap.xml, в свою очередь, - подсказка, а не приказ: робот не обязан индексировать всё, что в нём перечислено.
II. Что писать в robots.txt
Файл лежит строго в корне: site.ru/robots.txt. Для сайта услуг он обычно укладывается в 10-20 строк. Базовый набор выглядит так:
- User-agent: * - правила для всех роботов; отдельные блоки для Яндекса и Google нужны только если правила различаются.
- Disallow для служебных разделов: админка, корзина, личный кабинет, внутренний поиск, страницы сортировки.
- Clean-param для Яндекса - склеивает адреса с метками utm_source, yclid, gclid и параметрами сортировки.
- Sitemap: https://site.ru/sitemap.xml - полный адрес карты сайта, можно несколько строк.
- Allow для CSS, JS и картинок, если родительская папка закрыта: без них робот видит сайт сломанным.
Директива Host давно не учитывается Яндексом. Главное зеркало (с www или без, http или https) задают 301-редиректом и в Вебмастере, а не строкой в robots.txt.

III. Что включать в sitemap.xml
В карту сайта попадают только канонические страницы, которые отдают ответ 200 и должны быть в поиске: главная, услуги, категории, товары, статьи, кейсы, контакты. Всё, что закрыто в robots.txt, помечено noindex, редиректит или указывает canonical на другой адрес, из sitemap убирают - иначе поисковик получает противоречивые сигналы.
| Тип страницы | В sitemap | В robots.txt | Комментарий |
|---|---|---|---|
| Услуги и посадочные | Да | Открыты | Главные денежные страницы |
| Статьи блога | Да | Открыты | Обновлять lastmod при правке |
| Фильтры и сортировки | Нет | Clean-param или Disallow | Кроме посадочных фильтров со спросом |
| Корзина, кабинет, поиск | Нет | Disallow | Технические разделы |
| Страницы «спасибо» | Нет | Disallow + noindex | Иначе искажают цели в аналитике |
| Пагинация | Обычно нет | Открыта | Робот должен доходить до товаров |
Ограничения формата: до 50 000 адресов и до 50 МБ в одном файле. Крупные сайты делят карту на части - отдельно услуги, товары, статьи - и связывают их индексным файлом. Так в Вебмастере сразу видно, какой раздел индексируется хуже. Карта должна генерироваться автоматически: ручной sitemap устаревает после первой же новой статьи.
Картинки и видео тоже можно описать в карте сайта отдельными расширениями. Для сайтов, где много работ в портфолио или роликов, это помогает поисковику находить медиафайлы и связывать их со страницами. Для обычного сайта услуг из 20-50 страниц достаточно основной карты страниц.
IV. 8 правил настройки
- Один robots.txt в корне основного зеркала, ответ 200, размер до 500 КБ.
- Закрывать разделы, а не отдельные страницы: правило на папку надёжнее списка из сотни адресов.
- Не закрывать CSS, JS и изображения - поисковику нужно отрисовать страницу, чтобы оценить мобильную версию.
- Метки и параметры склеивать через Clean-param, а не плодить Disallow на каждую метку.
- В sitemap только канонические адреса с ответом 200, без редиректов и noindex.
- Дату lastmod менять только при реальном изменении контента, иначе робот перестаёт ей доверять.
- Карта генерируется сайтом сама при публикации новой страницы или статьи.
- После каждого релиза или переноса сайта проверять оба файла руками - это 5 минут.
В проектах студии оба файла собираются вместе с сайтом, а не дописываются потом. На ayvazzovsky.academy у каждого урока своя посадочная страница, поэтому новые уроки попадают в карту сайта сразу при публикации, а личный кабинет и служебные адреса закрыты от обхода. Это типовая схема для сайта, где страницы добавляются постоянно.
V. Ошибки, которые стоят трафика
Самая дорогая ошибка - перенести сайт с тестового домена вместе с Disallow: /. Разработчики закрывают тестовую копию от индексации, и если это не снять при запуске, сайт выпадает из поиска за несколько недель. Проверяйте robots.txt в первый же день после переезда.
- Закрыта страница с формой заявки или вся папка /uslugi/ из-за слишком широкого правила.
- В sitemap сотни адресов с редиректами после смены структуры URL.
- Карта отдаёт старые страницы, которые давно удалены и отвечают 404.
- Страница закрыта в robots.txt и одновременно помечена noindex - робот не может прочитать noindex, и страница остаётся в индексе.
- Конструктор генерирует свою карту, а рядом лежит устаревшая ручная - поисковику отдаются обе.
При переносе с конструктора такие ошибки встречаются чаще всего: старые адреса, дубли карт, чужие правила. Поэтому перенос сайта в студии стоит от 80 000 ₽ и включает редиректы, новую карту и проверку индексации, а не только вёрстку.
VI. Как проверить за 15 минут
В Яндекс Вебмастере есть инструмент «Анализ robots.txt»: вставляете список адресов - услуги, статьи, форму заявки - и видите, какие разрешены. Затем раздел «Файлы Sitemap»: карта должна быть обработана без ошибок, а число адресов в ней - сопоставимо с числом страниц в поиске. В Google Search Console аналогичный отчёт «Файлы Sitemap» и проверка URL.
Раз в месяц полезно сравнить три цифры: сколько адресов в карте, сколько в индексе и сколько исключено. Если исключённых больше, чем проиндексированных, причина обычно в дублях, canonical или слабых страницах, а не в самих файлах. Если нужен аудит и доработка сайта целиком, это делает разработка сайтов и SEO студии: самописный сайт на React от 80 000 ₽ за 1-2 недели от материалов, служебные файлы входят в сборку.
Отдельно проверьте, как сайт отвечает роботу. Robots.txt должен отдавать код 200: если сервер на этот адрес отвечает 5xx, поисковик может временно считать закрытым весь сайт, а при ответе 404 - открытым целиком. Карта сайта тоже должна отдаваться с кодом 200 и правильной кодировкой, без HTML-страницы ошибки вместо XML. Такие сбои часто появляются после смены хостинга или подключения защиты от ботов, которая по ошибке блокирует и поисковых роботов.
Для сайтов, где страницы публикуются каждый день, полезен ещё один шаг: после выхода партии статей отправлять ключевые адреса на переобход в Вебмастере. Лимит на переобход ограничен, поэтому в первую очередь стоит отправлять новые услуги и статьи, которые должны вести к заявке, а не все подряд. Первые показы по новым статьям обычно видны уже в первые недели после индексации, и эффект накапливается с каждой следующей партией.
И последнее: не путайте служебные файлы с защитой. Robots.txt открыт всем, и перечислять в нём секретные разделы вроде /admin-panel-2026/ - значит показать их адрес любому любопытному. Закрытые разделы защищают паролем и авторизацией, а в robots.txt достаточно общего правила на папку без подробностей.
VII. Короткий итог
Robots.txt закрывает мусор от обхода, sitemap.xml ведёт робота к важным страницам. Оба файла должны генерироваться автоматически, не противоречить canonical и noindex и проверяться после каждого релиза. Сами по себе они не поднимут позиции и не принесут заявки - они лишь убирают технические препятствия, чтобы контент и услуги вообще попали в поиск. Трафик дают страницы и статьи, а когда их нужно много, помогает массив материалов и генерация целевых клиентов параллельно с SEO.
Наши работы
Сайты, которые студия уже запустила
Четыре проекта N3MIROFF, которые можно открыть прямо сейчас и посмотреть, как они работают.
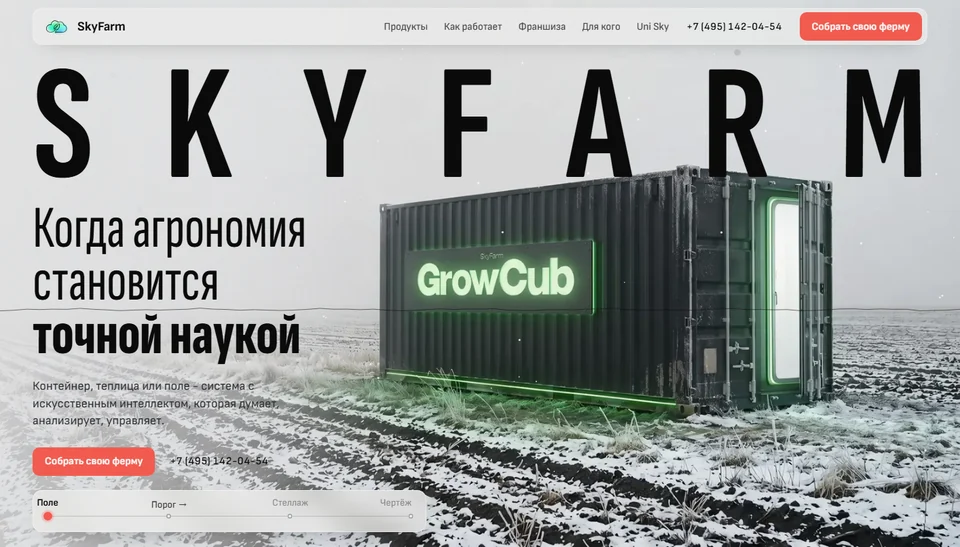
Агротех с ИИ
SkyFarm ↗
Редизайн сайта систем выращивания: первый экран с контейнерной фермой, схема работы из трёх шагов, карусель продуктов и экран приложения.
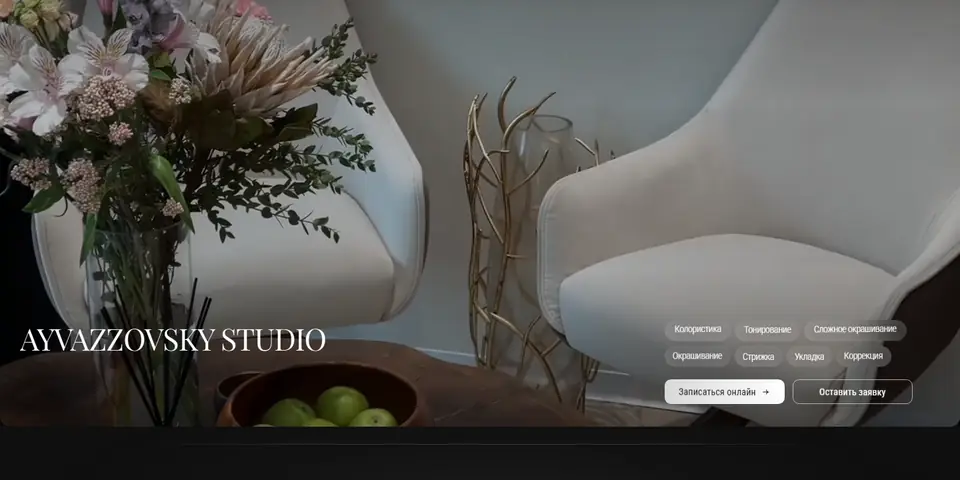
Сайт салона
ayvazzovsky.com ↗
Салон сложного окрашивания в Москве: онлайн-запись, видео работ, портфолио и команда. Переехал с Тильды на свой хостинг.
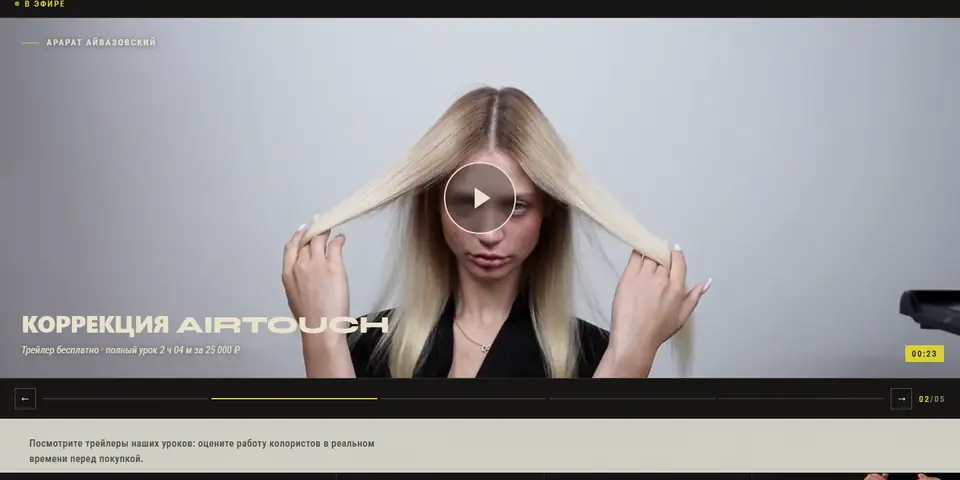
Онлайн-академия
ayvazzovsky.academy ↗
Видеоуроки колористики: каталог, посадочные страницы уроков, личный кабинет и промокоды.
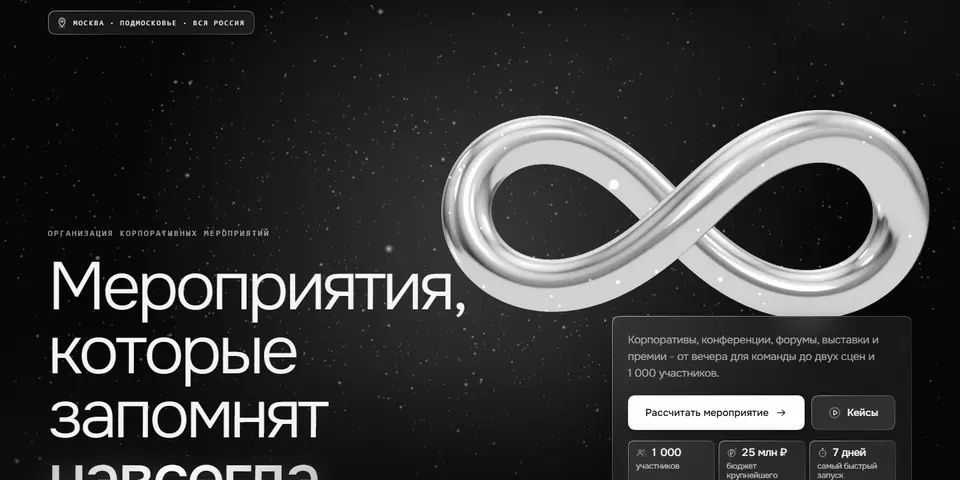
Event-агентство
navsegda-event.ru ↗
НАВСЕГДА: корпоративы и конференции - услуги, кейсы, этапы работы и расчёт мероприятия.
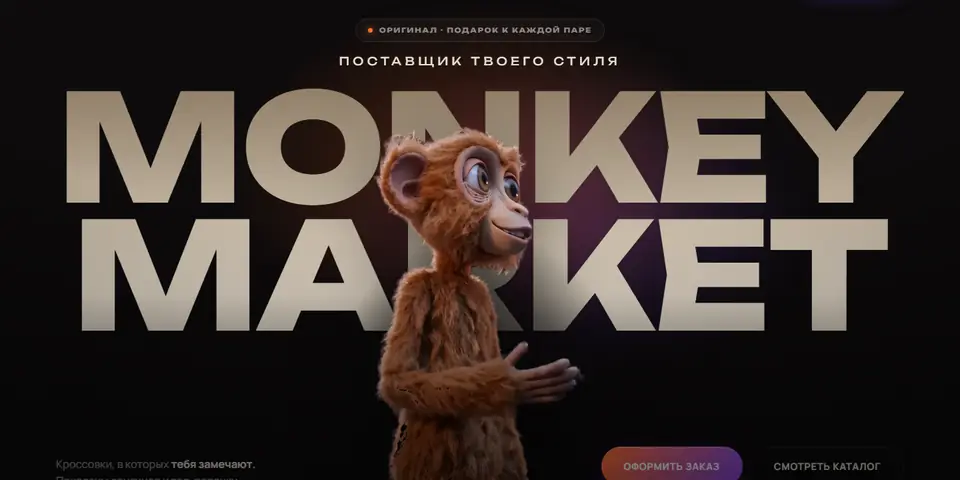
Витрина магазина
Monkey Market ↗
Премиальная витрина магазина кроссовок с заказом в Telegram.
Услуги студии по теме: разработка сайтов под ключ и SEO-продвижение статьями.

Сайт не индексируется так, как должен?
Проверим служебные файлы, дубли и структуру и скажем, что мешает страницам попасть в поиск.
Частые вопросы
Можно ли убрать страницу из поиска только через robots.txt?
Надёжно - нет. Robots.txt запрещает обход, но страница с внешними ссылками может остаться в выдаче. Для удаления нужен мета-тег noindex при открытом обходе или ответ 404/410; выпадение обычно занимает 1-4 недели.
Сколько адресов можно положить в один sitemap.xml?
До 50 000 адресов и до 50 МБ без сжатия. Если больше, карту делят на несколько файлов и объединяют индексным sitemap.
Как часто обновлять карту сайта?
Автоматически при каждой публикации или изменении страницы. Ручная карта устаревает с первой новой статьёй, а lastmod стоит менять только при реальной правке контента.
Нужно ли закрывать пагинацию в robots.txt?
Обычно нет. Через страницы пагинации робот доходит до товаров и статей; закрыв их, вы рискуете оставить глубокие страницы без индексации. В sitemap пагинацию обычно не включают.
Сколько стоит настроить sitemap и robots.txt?
Как отдельная работа это 1-2 часа специалиста, фрилансеры обычно берут от нескольких тысяч рублей. В студии оба файла входят в сборку сайта на React от 80 000 ₽ и в перенос с конструктора от 80 000 ₽.
Разберём техническую базу вашего сайта
Оставьте заявку - посмотрим robots.txt, sitemap и индексацию и предложим, что исправить в первую очередь.
Получить целевые заявки → Telegram